J-MoshiVis
リアルタイム性と自然性を両立する
フルデュプレックス日本語マルチモーダル対話AI

Encoder
BackboneJ-Moshi (Helium)
Transformer
なぜ「見て・聞いて・即座に話す」AIが必要なのか
近年、AIが物理的な身体を持ち、実世界で人と相互作用する「Physical AI」の研究が急速に進展しています。産業分野(工場や倉庫)ではロボットの実用化が進んでいますが、家庭や介護現場のような非構造化環境(状況が予測不可能で常に変化する環境)での普及は限定的です。
非構造化環境で人と共生するためには、ロボットが「その場の状況(視覚情報)」を即座に取り込み、文脈に応じて柔軟に対話や行動を調整する能力が不可欠です。メラビアンの法則によれば、人間のコミュニケーションにおいて言語情報が占める割合はわずか7%であり、視覚情報(表情や状況)が55%、聴覚情報(声のトーンや間)が38%を占めるとされています。
本研究は、言葉だけでは捉えられない「暗黙の情報」をマルチモーダルに統合理解し、人間に寄り添った自然なコミュニケーションを実現する技術基盤を確立することを目的としてスタートしました。
解決すべき3つの技術的空白
理想のインタラクションを実現する上で、既存技術には以下のような決定的な欠落が存在していました。
破滅的忘却を防ぐ非破壊的統合アーキテクチャ
本研究で提案する「J-MoshiVis」は、事前学習済みの日本語音声対話モデル「J-Moshi」をバックボーンとし、視覚エンコーダ(SigLIP: gemma2_448)を統合したモデルです。
最大の工夫は「能力の分離と統合」に基づく学習設計です。J-Moshiが既に獲得している高度な日本語能力や音声の韻律知識を破壊(破滅的忘却)しないよう、音声基盤モデルと視覚エンコーダの重みは完全に凍結(Frozen)します。
代わりに、各Transformer層にCross-Attention Adapterを挿入し、この部分のみを学習対象としました。さらに、2層MLPによる動的ゲーティング機構(Gating)を導入しています。これにより、「画像についての質問」ではゲートを開いて視覚情報を取り込み、「単なる挨拶や雑談」ではゲートを閉じて基盤モデル本来の言語挙動を維持するという、文脈に応じた柔軟なモダリティの切り替えを実現しました。
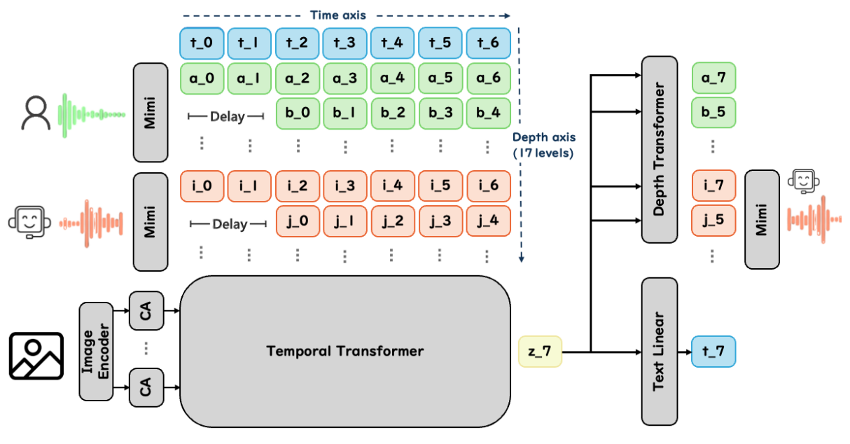 図1 J-MoshiVisのアーキテクチャ
1,000時間超のデータセット自動構築パイプライン
学習に必須となる大規模データを、最新のAI群を連携させて全自動で生成する仕組みを構築しました。最終的に55,214件(約1,014時間分)のデータセットを整備しました。
Step 1: VLMによる対話テキスト生成
既存の画像キャプション(説明文)をそのまま使うと、機械的な読み上げモデルになってしまいます。そこで、視覚言語モデルQwen2.5-VLにユーザー役とアシスタント役をロールプレイさせ、画像を題材とした8〜16ターンの「自然な口語の日本語対話」を生成させました。
Step 2: 音声合成と「間」の設計
生成されたテキストをStyle-Bert-VITS2を用いてステレオ音声に合成。さらに、人間同士の自然な会話の統計分布に基づき、発話と発話の間のギャップ(ポーズ時間)をランダムに抽出し、対話の「間」をアルゴリズム的に再現しました。
Step 3: 時系列アライメントと再整合処理
Moshiの学習には、音声トークン(80ms単位)とテキストトークン(SentencePieceによるサブワード)を同一時間軸で並列処理するためのミリ秒単位の同期情報が必要です。whisper-timestampedで取得した単語レベルの時刻を文字レベルに均等分割し、SentencePieceのトークン境界に合わせて再配分する独自のアライメントアルゴリズムを実装しました。
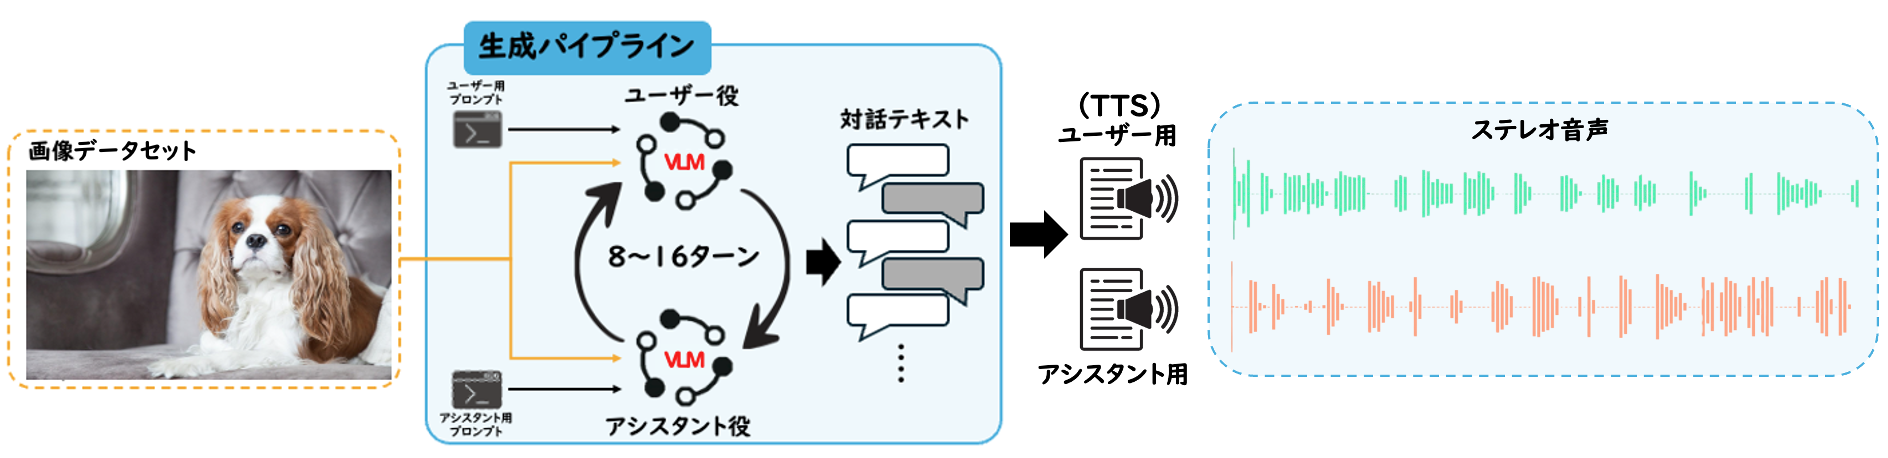 図2 データセット構築パイプライン
視覚情報を理解する対話の実現
モデルは入力画像の内容を踏まえた日本語音声対話を生成できるようになりました。 以下は、J-MoshiVisに画像を入力した際の対話音声サンプルです。ステレオ音声の上段(緑)がユーザー側、下段(白)がAI側の発話です。 一方で、日本語としての不自然な表現が残っていることや、幻聴が発生するなどの課題も確認されました。
今後の展望:デュアルシステム構想
本研究を通して、単一のモデルで「高速な音声生成」と「深い視覚推論」を両立させることの難しさが浮き彫りになりました。 今後は、Figure社のロボット制御AI(Helix)などでも採用されている二系統構成(デュアルシステム)への拡張を構想しています。
- System 1 (Fast & Reactive)J-MoshiVisが担当。音声と画像を自己回帰的に処理し、平均160msの超低遅延で即座に相槌や返答を生成する高速モジュール。
- System 2 (Semantic Reasoning)7Bクラスの大規模VLMが担当。低い周波数(数Hz)で視覚・言語入力を深く推論し、生成された文脈ベクトルをSystem 1へ非同期に注入することで、応答の内容的正確性を担保する。
このアプローチにより、汎用性と高速性のトレードオフを解消し、将来的に介護や育児現場で「人間の感情や状況にリアルタイムで寄り添うロボット」の頭脳となる基盤モデルの完成を目指します。
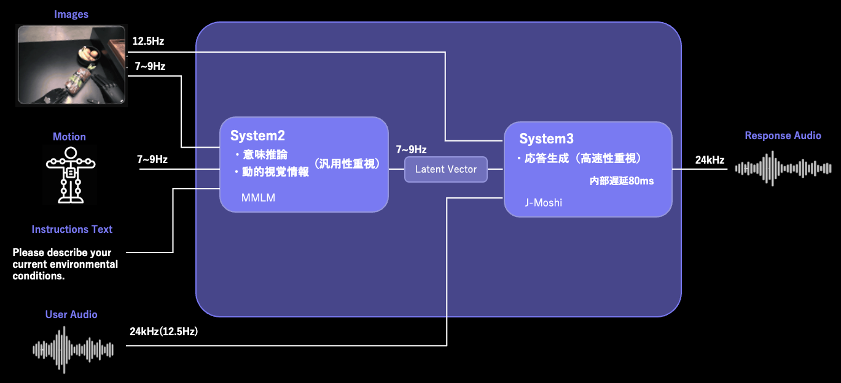 図4 デュアルシステム構想図