勉強会の背景
現在のプロジェクトにおいて、ChatGPTやStable Diffusionなどの生成AIを活用する機会が急増しています。しかし、APIを単に呼び出すだけの「ブラックボックス化」した利用に留まっており、モデルの得意・不得意の判断や、自社データを用いた効果的なカスタマイズ手法(ファインチューニング等)の選定において、技術的な確証を持てないという課題がありました。
ゴール設定
本勉強会では、表層的な使い方ではなく、裏側で動いている数理モデルの直感的な理解を目指し、以下の3点を持ち帰ってもらうことをゴールに設定しました。
勉強会の構成 (全14日間)
プロジェクトメンバーのスキルレベルや目的に合わせ、最初の7日間を「導入編(ハンズオン)」、中盤3日間を「基礎編(Deep Learning概要)」、後半4日間を「応用編(深層生成AI・LLM)」に分けた計14日間の長期カリキュラムを設計しました。
ハンズオンでまずはAIを体験し、その後、各モデルの裏側にある「数理的なイメージ」や「アーキテクチャの本質」を徐々に掴んでいくステップアップ方式を重視しています。
| 日程 | フェーズ | 主な内容 |
|---|---|---|
| Day 1-7 | ハンズオン | AIモデルの実行体験(画像分類、物体検出、セグメンテーション、音声、LLM等) |
| Day 8-10 | 基礎編 | AIの歴史、機械学習・Deep Learningの基礎と仕組み概要 |
| Day 11-12 | 応用編(言語) | LLMのアーキテクチャ(Transformer、Attention)、RAGやAdapter等 |
| Day 13-14 | 応用編(画像) | 深層生成モデルの概念と進化(VAEから潜在拡散モデル:LDM) |
導入編: AIモデル体験ハンズオン (Day 1-7)
本格的なDeep Learningの座学に入る前の最初の7日間では、チームメンバーが様々なAIモデルに直接触れて体験する「ハンズオンセッション」を実施しました。
画像分類、物体検出、セグメンテーション、音声認識、音声合成、LLM、RAGなど、主要なAIタスクについてそれぞれ100分のセッションを設け、理論だけでなく実際に手を動かして出力を確認するカリキュラムを通っています。代表的な実践内容をご紹介します。
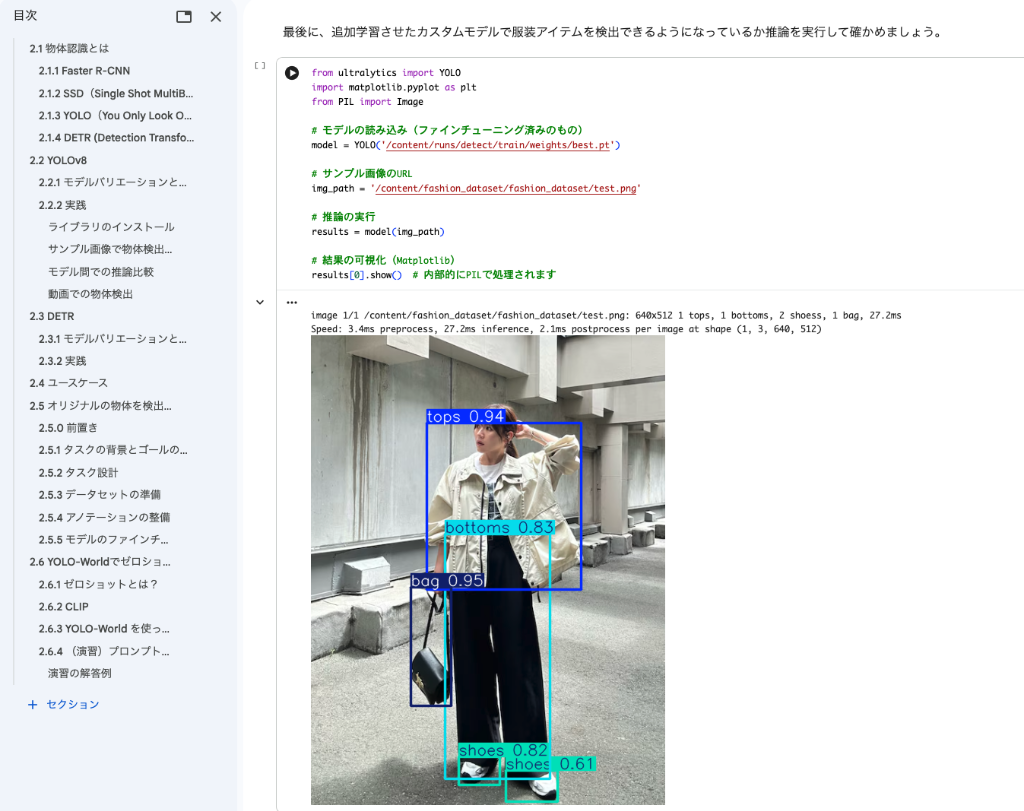
1. 物体検出(YOLO等の実践)
画像内の「どこに」「何が」あるのかを特定する物体検出タスクでは、YOLOなどのモデルを使用し、実際に推論コードを動かしてバウンディングボックスを描画する体験を行いました。
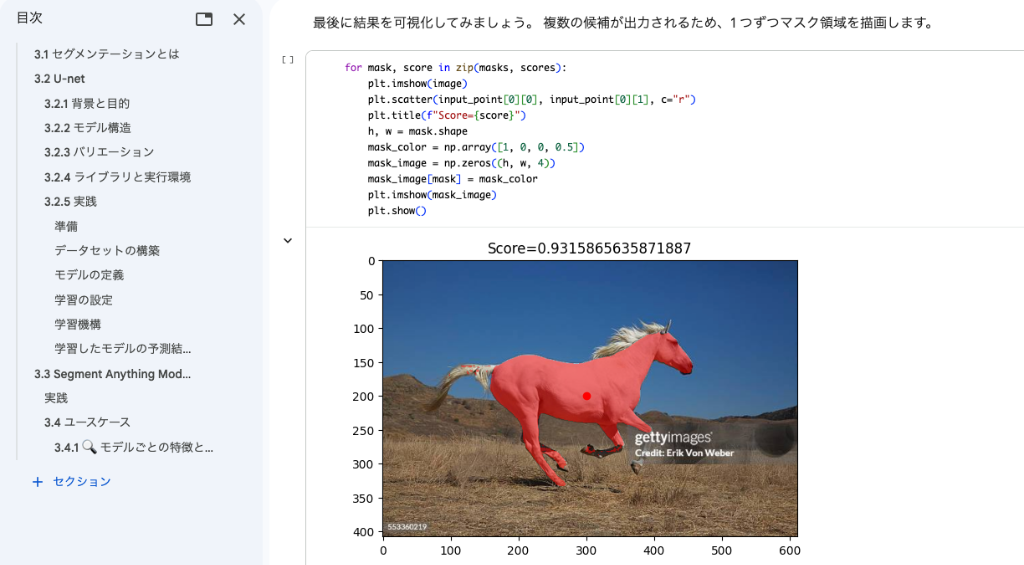
2. セグメンテーション(領域分割)
ピクセル単位で対象物を切り出すセグメンテーションでは、単純な矩形だけでなく、対象の輪郭に沿って領域を抽出するタスクを実践。複雑な形状の推論精度をプログラム上で視覚的に確認しました。
この他にも音声認識やRAGなど多岐にわたるトピックを実際に触ることで、各モデルの「得意・不得意」の肌感をチーム全体で共有し、後半のディープな仕組みの解説(基礎編・応用編)へとスムーズに繋げることができました。
基礎編: Deep Learning基礎 (Day 8-10)
ハンズオンを終えた後のDay 8〜10では、いきなり複雑な論文の内容に入るのではなく、まずはチーム全体の「基礎リテラシー」を底上げすることを目的としました。
共通言語の構築
AI、機械学習、ディープラーニング、生成AIという言葉の包含関係を整理し、それぞれの得意領域をチーム内で共有しました。この基礎編を経たことで、参加者全員がパーセプトロンからニューラルネットワークに至る基礎知識を持った状態で、終盤の応用編(AIのメカニズム理解)へとスムーズに移行することができました。
応用編 前半: LLMのメカニズムと実践 (Day 11-12)
Day 11からの応用編ではテキストを扱うLLMに頭を切り替え、言語モデルのアーキテクチャとそのプロジェクト応用について解説しました。
1. LLMの心臓部(TransformerとAttention)
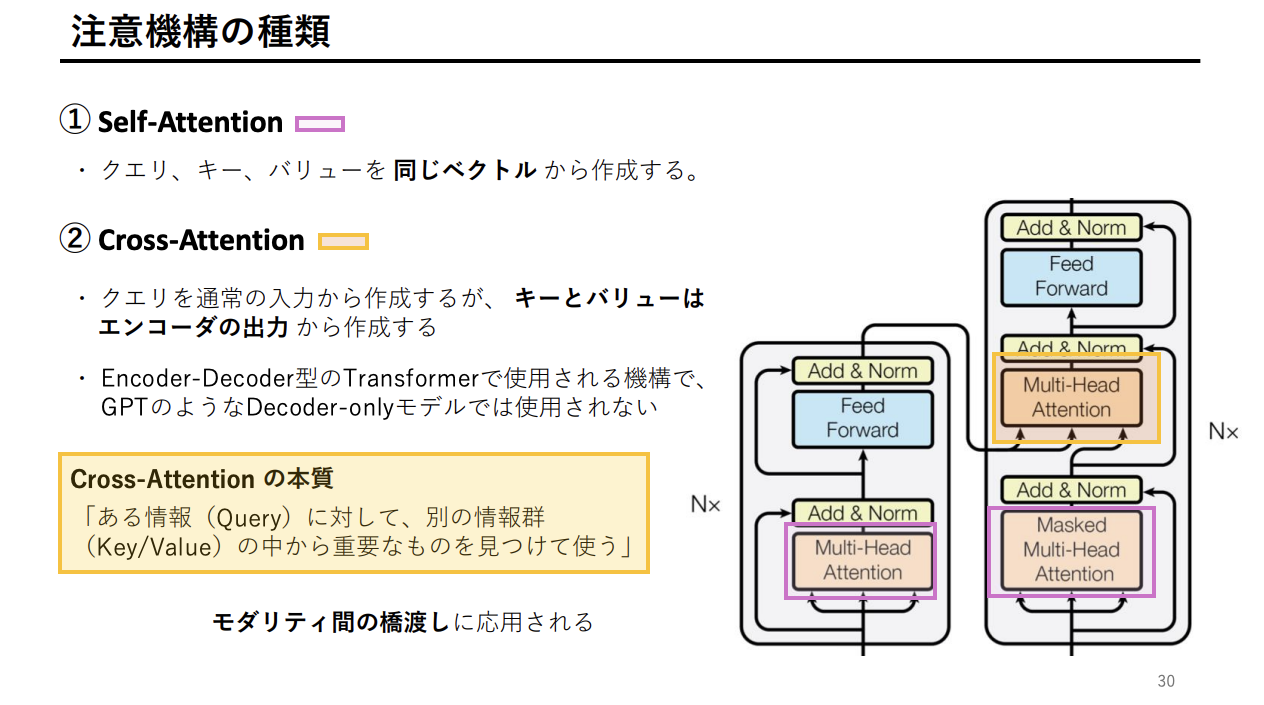
テキスト生成モデルに話題を移し、Googleが2017年に発表した画期的なアーキテクチャ「Transformer」を紹介しました。RNN等の過去の手法を捨て、Attention(注意機構)のみを使用することで、長距離の文脈理解と高い並列計算効率を実現したことを説明しました。
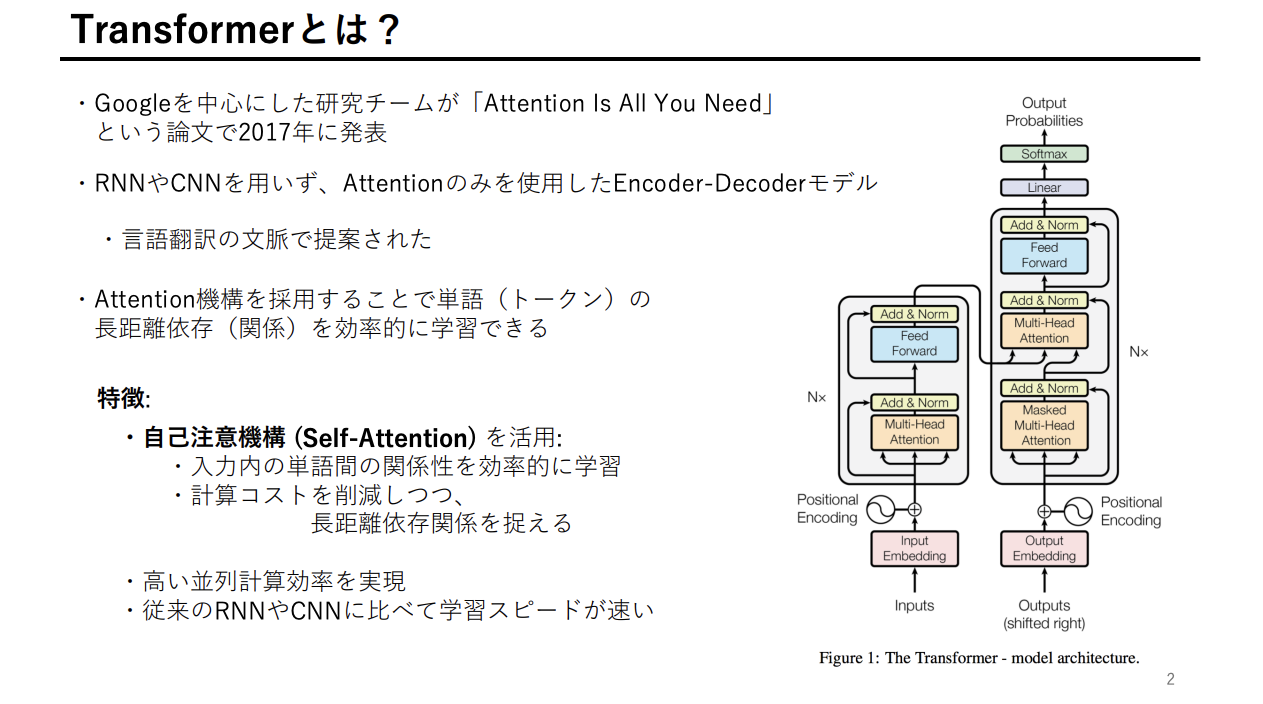
特に、Self-Attention(入力データ同士の関係性を学習する)と、Cross-Attention(ある情報に対して別情報から重要なものを見つけて使う)の違いを解説し、これがマルチモーダル(画像とテキストの橋渡し等)にも応用される本質であることを強調しました。
2. 学習コストを下げる工夫(事前学習とAdapter)
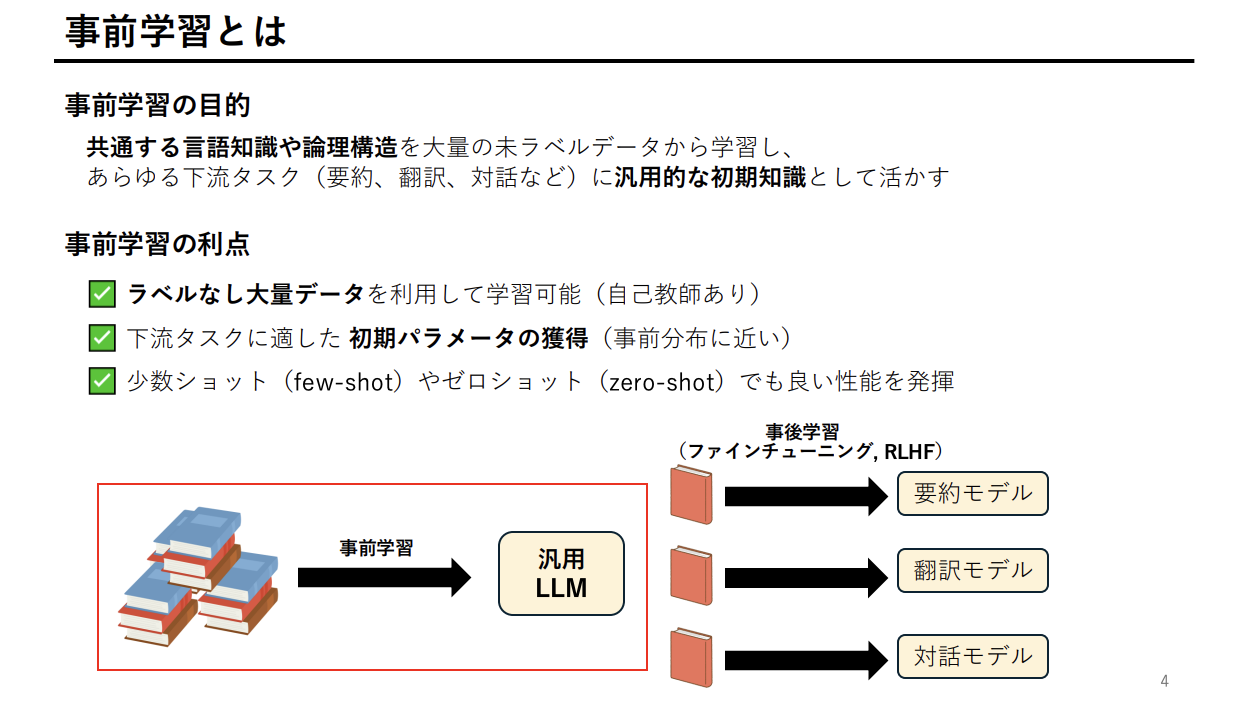
最後に、これら巨大なモデルを実務でどうカスタマイズするかについて触れました。汎用的な「事前学習」モデルをベースにすることの利点を確認しました。
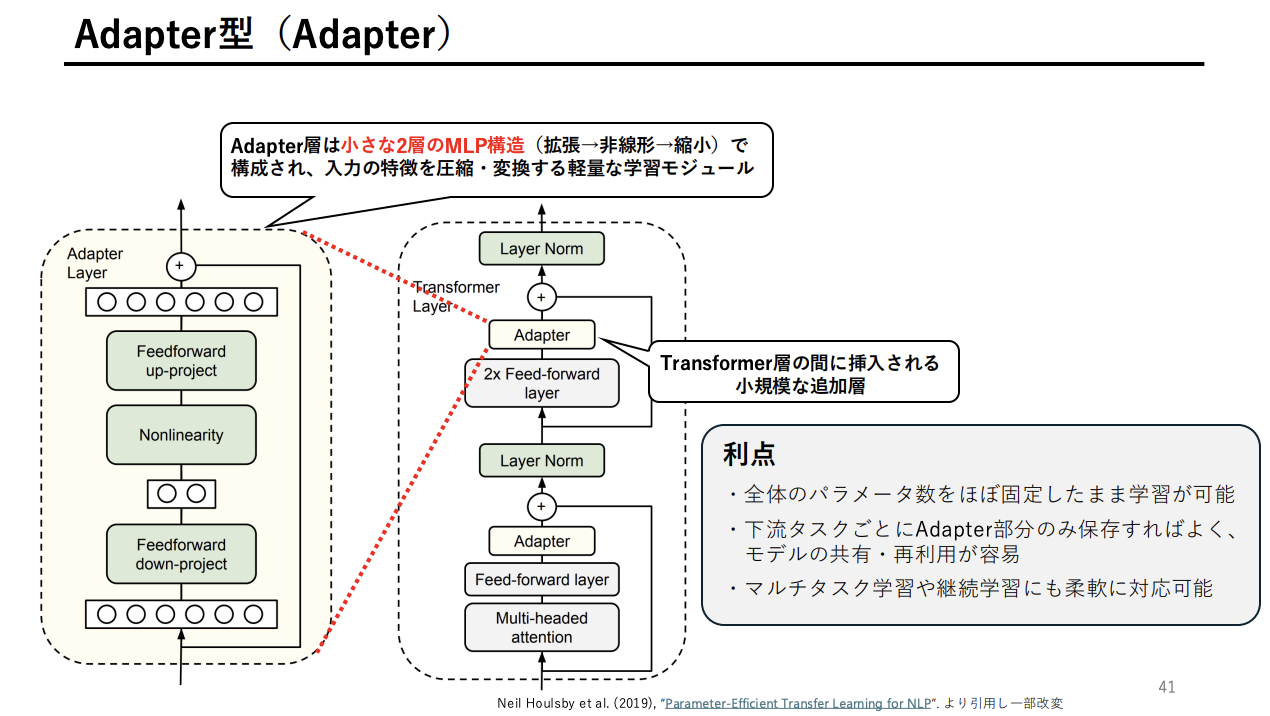
加えて、すべてのパラメータを再学習するフルファインチューニングではなく、Transformer層の間に軽量な追加層を挟み込んで学習させるAdapter型のファインチューニング手法を紹介。これにより、限られた計算リソースでもプロジェクト専用モデルが構築可能であることを提示しました。
応用編 後半: 深層生成AIと画像生成 (Day 13-14)
最後の2日間(Day 13〜14)では、画像生成分野の技術的な深掘りを行いました。画像生成AIの進化とその裏側にあるアプローチを辿り、数式に深入りしすぎず図解を中心にモデルの構造を「視覚で理解する」ことを目標としています。
1. 潜在空間の獲得(VAE)
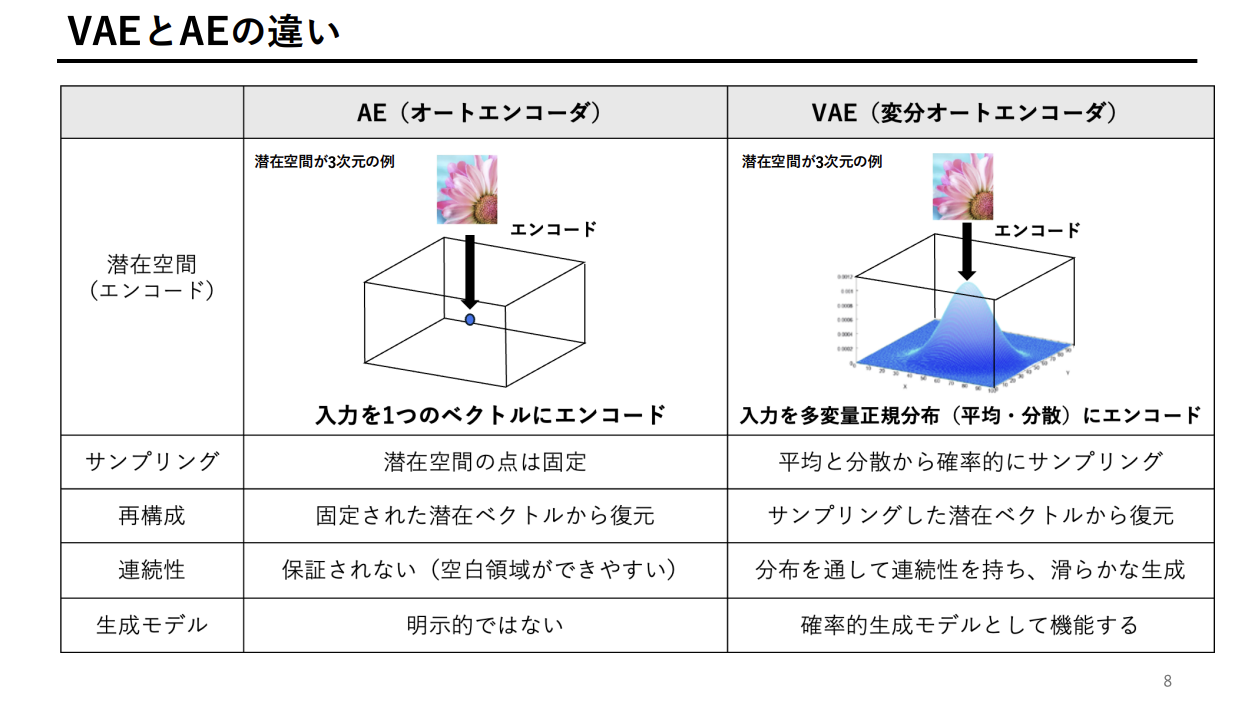
まず、データを圧縮して復元するオートエンコーダ(AE)の概念に触れ、生成モデルとして機能させるための変分オートエンコーダ(VAE)の違いを解説しました。入力を固定の点ではなく「分布」として捉えることで、滑らかな生成が可能になる点を共有しました。
2. ノイズからの復元(拡散モデルとLDM)
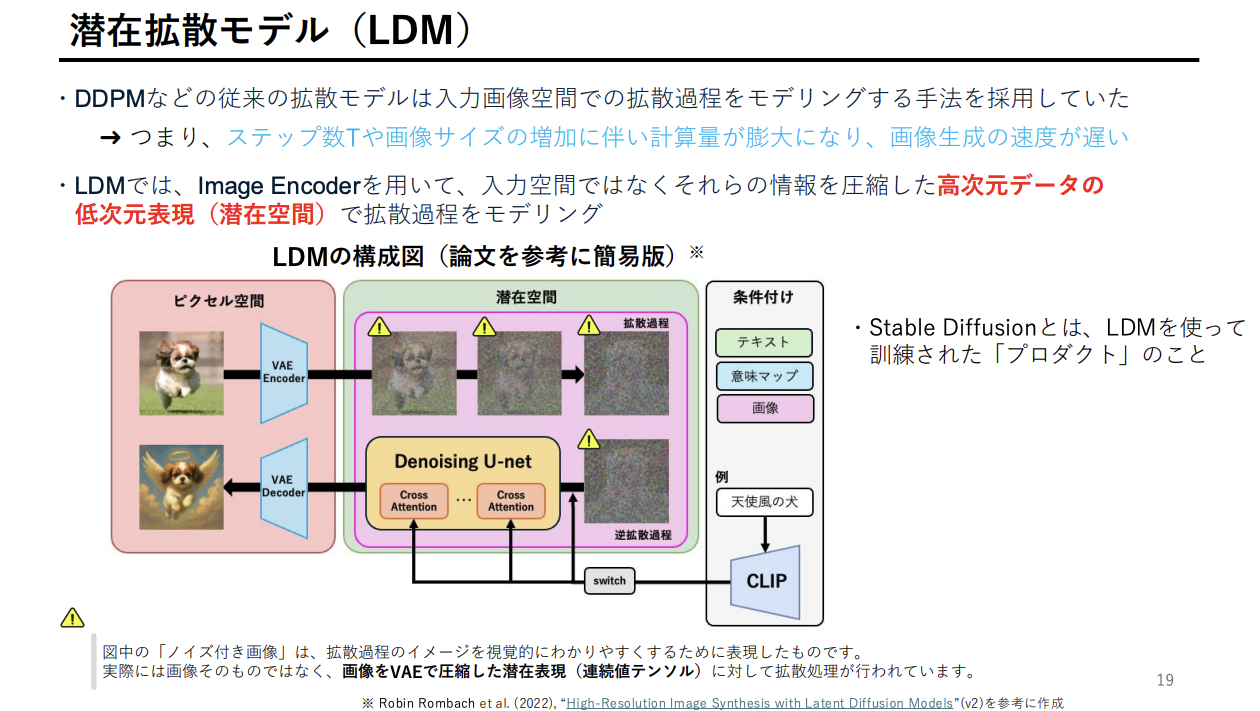
次に、現在の画像生成の主流である拡散モデルについて解説しました。ノイズを少しずつ除去していく「逆拡散過程」をニューラルネットワーク(U-Net等)で学習するアプローチです。
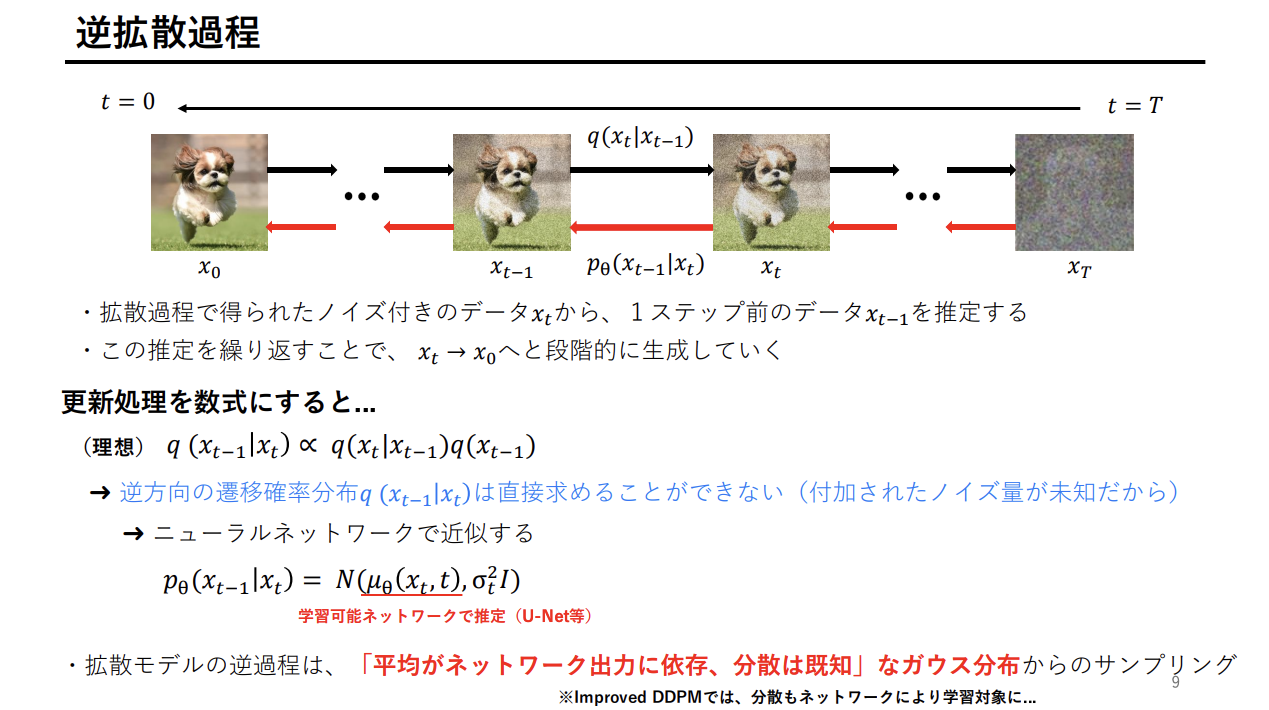
しかし、ピクセル空間でこれを計算すると膨大なコストがかかります。そこで、VAEのエンコーダを利用して「低次元の潜在空間」で拡散・逆拡散処理を行う潜在拡散モデル(LDM)がStable Diffusionの正体であることを解説し、処理速度向上の仕組みを理解してもらいました。
講師の気づき
逆拡散過程の遷移確率分布など、一部数式が含まれるスライドもありましたが、式自体の理解よりも「U-Net等を使って段階的にノイズを除去するネットワークを組んでいる」という直感的なイメージを伝えることに注力したのが結果的に良かったです。実務のエンジニアは「どこが学習可能なパラメータなのか(Adapter等)」が明確になると、一気に実装のイメージが湧くようです。
次のステップ
理論の理解が進んだため、次は実際にコードを動かすフェーズへと移行します。プロジェクト内で以下の取り組みを進める予定です。